Microsoft-Ausfall im November 2026: Was muss eigentlich noch passieren, bis ihr aufwacht?
Donnerstag, 12. November 2026, kurz nach 17 Uhr deutscher Zeit. Outlook antwortet nicht mehr. Teams stottert, Copilot schweigt, Admins kommen nicht in ihre Dashboards. Innerhalb einer Stunde melden Nutzer aus 74 Ländern Probleme. Am Freitagmittag – fast 20 Stunden später – spricht Microsoft von „ermutigenden Erholungssignalen“. Ermutigend. Für einen E-Mail-Dienst, auf dem laut Microsoft über 430 Millionen Menschen arbeiten.
Und jetzt kommt der Teil, der mich wirklich aufregt: Nichts davon ist überraschend. Es ist nicht einmal der erste große Microsoft-365-Ausfall dieses Jahres. Es ist der fünfte oder sechste, je nachdem, wie großzügig du zählst.
Dieser Text ist ein Rant. Aber einer mit Ersatzmodell. Denn Kritik ohne Ersatzmodell ist nur Geräusch.
Executive Summary
- Der Ausfall war kein Cyberangriff, sondern passierte im normalen Betrieb. Microsoft selbst nennt fehlschlagende Server-Health-Checks, eine überlastete Komponente für sichere Verbindungen und eine zurückgerollte Netzwerkkonfiguration. Das ist kein „Act of God“ – das ist Change Management im Hyperscale-Format.
- Betroffen waren nicht nur Firmen, sondern Staaten. Das US-Repräsentantenhaus, Japans Regierungs-IT, Singapurs Behörden-E-Mail, australische Sicherheitsbehörden, der Supreme Court der Philippinen, Teile des NHS.
- Der eigentliche Skandal ist nicht der Ausfall, sondern die fehlende Alternative. Japanische Behörden griffen zum Telefon, Finanzfirmen zum Fax. Das ist kein Notfallplan – das ist Improvisation mit Museumsausstattung.
- Die Abhängigkeit ist eine bewusste Managemententscheidung, kein Naturgesetz. Wer sie trifft, muss auch das Ausfallrisiko bilanzieren – tut aber fast niemand.
- SLA-Gutschriften ersetzen keinen Schaden. Du bekommst bestenfalls einen Teil deiner Lizenzgebühr zurück, nicht den verlorenen Arbeitstag.
- IT-Dienstleister, die ausschließlich Microsoft weiterverkaufen, sind Teil des Problems – nicht weil sie böse sind, sondern weil ihr Geschäftsmodell keine Exit-Option vorsieht.
- Next Step: Exit-Fähigkeit als KPI definieren, E-Mail und Kommunikation als kritische Infrastruktur behandeln, Second-Channel aufbauen. Nicht 2030. Im ersten Quartal.
Was am 12./13. November tatsächlich passiert ist
Bevor ich mich in Rage schreibe: die Fakten, Stand Freitagnachmittag.
| Zeitpunkt (MEZ) | Ereignis |
|---|---|
| Do, ca. 17:00 | Erste Meldungen: Outlook nicht erreichbar. Binnen einer Stunde Meldungen aus 74 Ländern auf Downdetector. |
| Do, ca. 19:00 | Peak in den USA: rund 138.000 gleichzeitige Outlook-Störungsmeldungen. Microsofts eigene Statusseite ist zeitweise ebenfalls nicht erreichbar. |
| Do, abends | Microsoft: Server bestehen automatische Health-Checks nicht; ein Prozess zum Aufbau sicherer Verbindungen ist überlastet. Rollback einer kürzlich ausgerollten Netzwerkkonfiguration. Deployments werden pausiert. |
| Fr, ca. 01:00 | Microsoft: Wiederhergestellte Server können „erneut unresponsive werden, sobald sie Traffic erhalten“. |
| Fr, Nacht | Maßnahmen „greifen nicht wie erwartet“, man suche „alternative Workstreams“ wegen anhaltender „Traffic-Management-Ungleichgewichte“. Nach über 12 Stunden nur „marginaler Erfolg“. |
| Fr, 12:11 | „Encouraging recovery progress in Europe“ – E-Mail-Zustellung verbessert sich schrittweise, Rückstau (Backlog) wird abgearbeitet. |
Ursache: Offiziell noch keine Root Cause. Microsoft schließt einen Cyberangriff aus und kündigt einen Abschlussbericht an. Australiens Innenminister Tony Burke berichtete, Microsoft habe den Vorfall selbst mit dem CrowdStrike-Desaster von 2024 verglichen – also einem fehlerhaften Update.
Wer betroffen war (Auswahl, laut öffentlichen Statements und Agenturberichten):
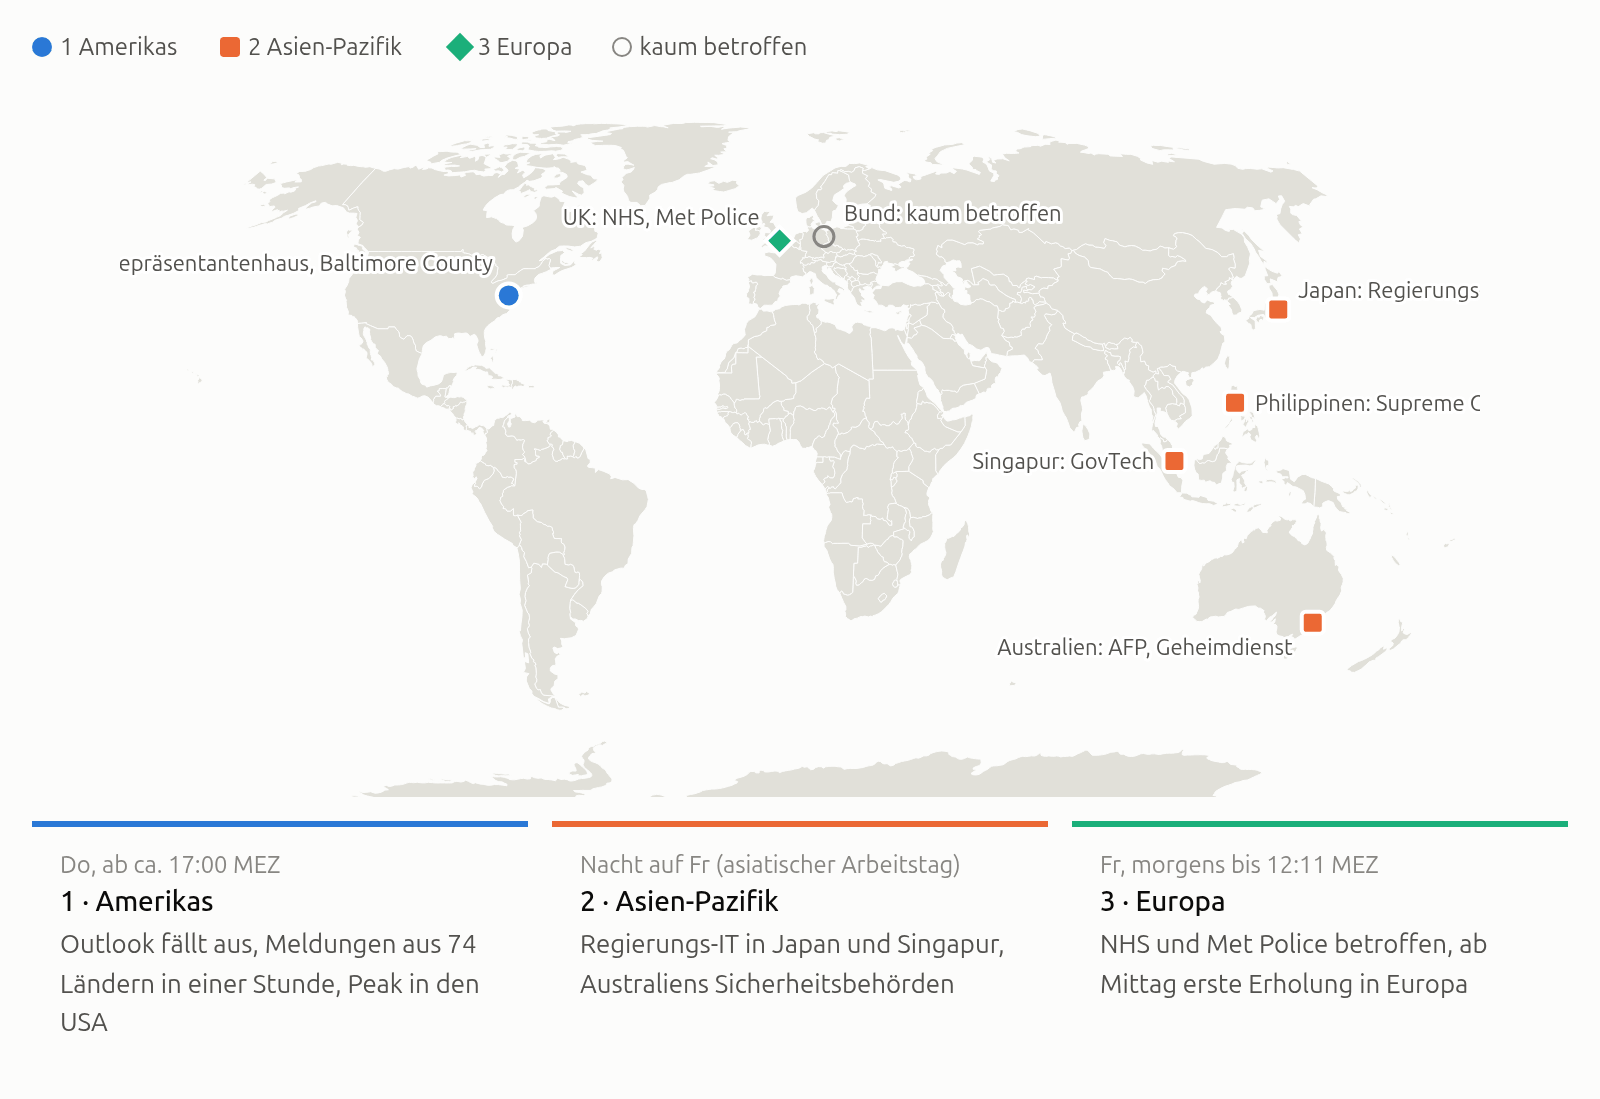
- USA: Repräsentantenhaus, Baltimore County (keine E-Mails, Notruf 911 lief weiter), Strafverfolgungsbehörden u. a. bei der Abwicklung von Kautionszahlungen
- Japan: Regierungs-IT-Infrastruktur betroffen; Behörden organisierten Telefone als Ausweichkanal
- Singapur: Government Technology Agency meldet: Regierungs-E-Mails ausgefallen
- Australien: ein Geheimdienst und die Bundespolizei (Australian Federal Police)
- Philippinen: Supreme Court mit verzögerter E-Mail-Bearbeitung
- Großbritannien: NHS-Einrichtungen teils auf Papier, Metropolitan Police mit eingeschränkter Online-Anzeigenerstattung
- Wirtschaft: Euronext (E-Mail-Störungen), Maersk (verzögerte Kundeninformationen), Richemont (Halbjahreszahlen kurz verschoben), Aviva (Backup-Lösung für Earnings Calls), Workhorse (Quartalszahlen um vier Tage verschoben), taiwanesische Finanzhäuser (Handelsbestätigungen per Fax), mindestens ein abgesagter Anleiherückkauf
- Deutschland: Laut Digitalministerium war die Bundesverwaltung „nicht umfassend betroffen“, für die Wirtschaft rechne man mit „sehr großer Betroffenheit“
Und als Bonus: Auch KI-Anbieter, deren Agenten auf Microsoft-365-Connectoren zugreifen, meldeten Störungen. Willkommen in der Kaskade.
Der Denkfehler: „Microsoft ist zu groß, um auszufallen“
Das ist der Hauptmythos, und er hält sich hartnäckiger als jede SEO-Legende über Keyword-Dichte.
Warum er so attraktiv ist:
- Authority Bias: Ein Konzern mit Milliarden-Budget für Infrastruktur muss doch zuverlässiger sein als dein eigener Exchange-Server im Keller. Stimmt sogar – im Durchschnitt. Aber du lebst nicht im Durchschnitt, sondern im Ausfall.
- Social Proof: Alle nutzen M365. Die Regierung nutzt es. Die Konkurrenz nutzt es. Wenn alle ausfallen, fällt keiner auf. Das ist die IT-Version von „Niemand wurde je gefeuert, weil er IBM gekauft hat“.
- Verantwortungsdiffusion: Wenn Microsoft ausfällt, ist Microsoft schuld. Wenn dein eigenes System ausfällt, bist du schuld. Für Entscheider ist der Hyperscaler deshalb vor allem eins: eine Haftungsauslagerung für die eigene Karriere.
- Sunk Cost: Nach Jahren der Migration in Tenant, Teams-Strukturen, SharePoint-Ablagen, Power-Automate-Flows und Copilot-Lizenzen fühlt sich jede Alternative an wie ein Abriss.
Warum er im Betrieb gefährlich ist:
Größe schützt nicht vor Ausfällen. Größe vergrößert den Blast Radius (den Wirkungsradius eines einzelnen Fehlers). Ein fehlerhafter Change in Redmond legt nicht einen Mandanten lahm, sondern Parlamente, Polizeien und Börsenbetreiber auf drei Kontinenten gleichzeitig. Das ist kein Bug. Das ist die Architektur.
Das klingt gut auf einer Folie – und scheitert im Betrieb.
Realitätsabgleich: Das hier ist eine Serie, kein Einzelfall
Wer jetzt „kann ja mal passieren“ sagt, hat das Jahr 2026 verschlafen:
| Datum 202 | Vorfall |
|---|---|
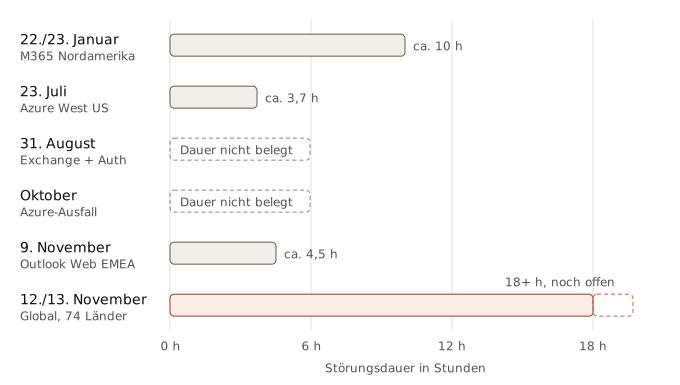
| 22./23. Januar | Microsoft 365 in Nordamerika fast 10 Stunden gestört; Microsoft nennt hohe Last bei reduzierter Kapazität während Wartungsarbeiten |
| 23. Juli | Netzwerkausfall in der Azure-Region West US reißt Azure und mehrere M365-Dienste mit |
| 31. August | Exchange-Online-Störung weitet sich auf Teams, SharePoint, OneDrive, Purview und Defender XDR aus; vorläufige Ursache: Authentifizierungskonfiguration |
| Oktober | Azure-Ausfall mit Auswirkungen auf Produktivitätsdienste weltweit |
| 9. November | Outlook im Web in EMEA rund 4,5 Stunden gestört |
| 12./13. November | Globaler Ausfall, 74 Länder, Regierungen betroffen, rund 18+ Stunden |
Sechs relevante Vorfälle in elf Monaten. Wenn ein Lieferant deines Mittelstandsbetriebs so liefern würde, säße der Einkauf längst mit einer Lieferantenbewertung und einer Second-Source-Strategie im Meeting. Bei Microsoft? Wird verlängert. Mit Copilot-Upsell.
Wie es in echten Organisationen typischerweise scheitert:
- Kein Second Channel: Wenn Outlook und Teams gleichzeitig ausfallen, fehlt jeder interne Kommunikationsweg. Die Notfallkommunikation läuft dann über private WhatsApp-Gruppen. Glückwunsch zur DSGVO-Konformität.
- Notfallpläne existieren nur auf SharePoint. Ja, wirklich. Der Business-Continuity-Plan liegt im System, das gerade ausgefallen ist.
- Identität ist der Single Point of Failure. Entra ID hängt an allem. Fällt Authentifizierung, fällt alles – auch Dienste, die gar nicht von Microsoft sind, aber per SSO angebunden wurden.
- Niemand weiß, was es kostet. Es gibt keine Kennzahl für „Ausfallkosten pro Stunde Kommunikationsblackout“. Ohne Zahl keine Priorität, ohne Priorität kein Budget.
- Die Exit-Option wurde nie geprüft. Datenexport, Formatkompatibilität, Migrationsaufwand – unbekannt. Damit ist die „strategische Partnerschaft“ faktisch ein Lock-in mit Abo-Modell.
Wenn das deine Strategie ist, ist dein KPI „Hoffnung“.
Und jetzt zur Politik: Was muss eigentlich noch passieren?
Ich stelle die Frage ernsthaft. Was genau ist die Eskalationsstufe, ab der Regierungen handeln?
- CrowdStrike 2024: Flughäfen, Krankenhäuser, Banken weltweit lahmgelegt. Reaktion: Betroffenheit, Arbeitskreise, Positionspapiere.
- Mehrere Azure- und M365-Großausfälle 2025 und 2026. Reaktion: siehe oben.
- November 2026: Japans stellvertretender Kabinettschef erklärt, man „beobachte die Entwicklung genau“ und habe Telefone als Ausweichkanal organisiert. Ein Industriestaat der G7. Mit Telefonen. Als Plan B.
In Deutschland ist das Muster besonders entlarvend. Auf die Frage, warum der Bund überhaupt noch Microsoft-Dienste nutze, obwohl man ständig digitale Souveränität betone, verwies ein Sprecher des Digitalministeriums auf „mehrjährige Verträge“ der Vorgängerregierung. Man arbeite an Redundanzen.
Lass das kurz sacken. Die offizielle Antwort auf ein strategisches Abhängigkeitsrisiko lautet: Der Vertrag läuft halt noch.
Wer „Best Practices“ sagt, meint oft: „Ich will nicht begründen müssen.“ Wer „Vorgängerregierung“ sagt, meint: „Ich will nicht entscheiden müssen.“
Immerhin: In Bayern formulierte Digitalminister Fabian Mehring den bisher besten Satz der Debatte: „Wer nur einen Anbieter hat, hat keine Wahl – weder beim Preis noch beim Ausfall.“ Die SPD-Opposition im Landtag hält dagegen, ein bisschen Open-Source-Testbetrieb im Ministerium reiche nicht. Beide haben recht. Und beide beschreiben damit den Zustand nach Jahren der Ankündigungen.
Ein Bundestagsabgeordneter der CDU nannte Schleswig-Holstein ausdrücklich als Vorbild. Das Land hat den Ausstieg aus Microsoft-Produkten in der Verwaltung nicht nur angekündigt, sondern begonnen – mit allen Reibungsverlusten, die so ein Umstieg mit sich bringt. Das ist der Unterschied zwischen Souveränitäts-Rhetorik und Souveränitäts-Arbeit: Das eine ist ein Pressetermin. Das andere ist ein Migrationsprojekt mit Schmerzen.
Das ist nicht kompliziert. Es ist nur unbequem, weil es Verantwortung verlangt.
Was dabei gern übersehen wird: Es geht nicht nur um Verfügbarkeit. Ein US-Anbieter unterliegt US-Recht, inklusive CLOUD Act. Verfügbarkeit, Datenzugriff und politische Erpressbarkeit sind drei Seiten derselben Abhängigkeit. Dieser Ausfall hat nur die harmloseste der drei sichtbar gemacht.
Der Seitenhieb, den sich die Branche verdient hat: IT-Dienstleister als Lizenz-Durchreiche
Jetzt zu meinen Lieblingen. Nicht zu allen IT-Dienstleistern – es gibt hervorragende Häuser, die herstellerneutral beraten und seit Jahren vor genau diesem Szenario warnen. Ich meine ein bestimmtes Geschäftsmodell.
Du kennst es: Das Systemhaus, dessen Leistungsversprechen auf der Website aus drei Logos besteht – Microsoft, Microsoft und Microsoft Partner. Dessen Beratung bei jeder Anforderung zur selben Antwort führt: „Machen wir mit Teams. Oder SharePoint. Oder Power Automate. Copilot kommt dann im nächsten Schritt.“
Das Problem ist nicht Microsoft-Kompetenz. Das Problem ist Monokultur als Geschäftsmodell.
Wenn ein großer Teil deines Umsatzes aus CSP-Lizenzmargen, M365-Migrationen und Managed Services auf genau einem Stack besteht, dann bist du kein neutraler Berater. Du bist ein Vertriebskanal. Das ist legitim – aber dann nenn es nicht „strategische IT-Beratung“.
Und genau das wurde am Donnerstagabend zum Stresstest. Frag dich ehrlich, wie die Statusmeldung deines Dienstleisters lautete. Wenn sie sinngemäß „Wir warten auf Microsoft“ hieß, weißt du Bescheid.
Was hast du in diesem Moment eingekauft? Eine Ticket-Weiterleitung mit Rechnungsstellung. Keine Resilienz, keine Alternative, keinen Plan B. Denn ein Plan B hätte eine Architektur erfordert, die der Dienstleister nie verkauft hat – weil sie nicht im Partnerprogramm vorkommt.
Tools lösen keine Probleme. Sie skalieren höchstens – auch Chaos. Und Dienstleister, die nur ein Tool kennen, skalieren dieses Chaos mit Wartungsvertrag.
Die Frage, die du deinem IT-Dienstleister ab Montag stellen solltest: „Wie lange brauchen wir, um bei einem 24-Stunden-Ausfall von M365 intern und mit Kunden kommunikationsfähig zu bleiben – und was kostet das?“
Wenn die Antwort mit „Microsoft hat ein SLA von 99,9 %“ beginnt, hast du deine Antwort.
Definitionen und Abgrenzungen (kurz, weil nötig)
- Hyperscaler: Cloud-Anbieter mit global verteilter Infrastruktur im Massenmaßstab – praktisch Microsoft, AWS, Google.
- Blast Radius: Wie viele Systeme, Kunden und Regionen ein einzelner Fehler gleichzeitig trifft.
- Lock-in: Der Zustand, in dem ein Anbieterwechsel so teuer oder riskant ist, dass er faktisch nicht stattfindet.
- Exit-Fähigkeit: Die nachgewiesene (nicht behauptete) Fähigkeit, einen Dienst innerhalb eines definierten Zeitraums zu ersetzen.
- Digitale Souveränität: Nicht Autarkie, sondern Wahlfreiheit. Die Fähigkeit, kritische Systeme zu verstehen, zu kontrollieren und bei Bedarf zu wechseln.
- SLA-Gutschrift: Eine teilweise Erstattung der Lizenzgebühr bei Unterschreitung der zugesagten Verfügbarkeit. Kein Schadensersatz für Betriebsausfall.
Strategie und Priorisierung: Kein Big Bang, sondern 80/20
Jetzt der Teil, für den du eigentlich hier bist. Denn „raus aus Microsoft, sofort!“ ist genauso unseriös wie „alles bleibt, wie es ist“.
Priorisiere nach Kritikalität, nicht nach Ideologie:
| Dienst | Kritikalität bei Ausfall | Typische Abhängigkeit | Priorität für Second Channel |
|---|---|---|---|
| E-Mail (extern) | Sehr hoch – Kunden, Behörden, Fristen | Exchange Online | Hoch |
| Interne Echtzeitkommunikation | Sehr hoch – Koordination im Notfall | Teams | Hoch |
| Identität / Login | Kritisch – alles hängt daran | Entra ID | Hoch (Break-Glass-Konzept) |
| Dateiablage | Mittel bis hoch | SharePoint / OneDrive | Mittel |
| Office-Bearbeitung | Mittel – lokal oft weiter möglich | M365 Apps | Niedrig |
| KI-Assistenz | Niedrig – Komfort, kein Betrieb | Copilot | Niedrig |
Trade-offs, ehrlich benannt:
- Kosten: Ein zweiter Kommunikationskanal kostet Lizenzen, Betrieb und Schulung. Rechne je nach Größe mit einem mittleren vier- bis niedrigen fünfstelligen Betrag pro Jahr für ein KMU.
- Komplexität: Zwei Systeme heißen zwei Sicherheitskonzepte, zwei Patchzyklen, zwei Benutzerverwaltungen.
- Akzeptanz: Ein Notfallkanal, den niemand kennt, nützt im Notfall nichts. Er muss geübt werden.
- Funktionsumfang: Europäische oder Open-Source-Alternativen sind in Teilen weniger integriert. Das ist der Preis der Wahlfreiheit – und er ist niedriger als die Ausfallkosten.
Operating Model: Wer ist eigentlich zuständig?
Die Antwort in den meisten Organisationen: niemand. „Die IT“ ist keine Rolle.
| Rolle | Verantwortung |
|---|---|
| Geschäftsführung | Akzeptiert oder reduziert das Konzentrationsrisiko bewusst und dokumentiert. Entscheidet über Budget für Exit-Fähigkeit. |
| IT-Leitung / CIO | Hält eine Abhängigkeitslandkarte aktuell, verantwortet Second Channel und Break-Glass-Zugänge. |
| Informationssicherheit / BCM | Testet Notfallszenarien mindestens halbjährlich, inklusive „M365 komplett 24 h weg“. |
| Kommunikation | Hat vorab Templates und Kanäle für externe Kommunikation ohne E-Mail. |
| Externer Dienstleister | Muss herstellerunabhängige Ausfallszenarien vertraglich mittragen – nicht nur „Ticket an Microsoft“. |
Pflegeaufwand: Realistisch zwei bis vier Personentage pro Halbjahr für Aktualisierung und Übung in einem KMU. Wer das für zu viel hält, sollte den Fall unten durchrechnen.
Umsetzung: Die SOP für die nächsten 90 Tage
- Abhängigkeitslandkarte erstellen (Woche 1–2). Welche Prozesse hängen an welchem Microsoft-Dienst? Inklusive SSO-angebundener Drittsysteme.
- Ausfallkosten beziffern (Woche 2). Formel siehe Fallbeispiel. Ohne Zahl kein Budget.
- Second Channel für Kommunikation einrichten (Woche 3–6). Ein unabhängiger Messenger oder Chat (z. B. Matrix-basiert oder ein europäisch gehosteter Dienst), eine Notfall-E-Mail-Domain bei einem anderen Provider, eine Telefonkaskade.
- Break-Glass-Konzept für Identität (Woche 4–6). Notfallzugänge, die nicht vom regulären Login-Pfad abhängen.
- Notfallplan offline verfügbar machen (Woche 6). Ausgedruckt. Ja, auf Papier. Und als PDF außerhalb des Tenants.
- Exit-Test für einen Dienst (Woche 8–12). Exportiere testweise eine Abteilung aus SharePoint oder Exchange in ein alternatives System. Miss Zeit, Datenverluste und Formatprobleme.
- Dienstleistervertrag nachschärfen (laufend). Verlange Ausfallszenarien jenseits von „wir eskalieren an den Hersteller“.
Bevor du optimierst: Geh das strukturiert an. Sonst optimierst du nur Zufall.
Messung und Controlling: Woran du erkennst, ob du besser wirst
| KPI | Definition | Zielwert (Orientierung) |
|---|---|---|
| Time-to-Communicate | Minuten bis zur ersten internen Notfallnachricht über den Second Channel nach Ausfall | < 30 Min. |
| Exit-Zeit pro Kerndienst | Geschätzte, idealerweise getestete Dauer für den Ersatz eines Dienstes | Dokumentiert und < 6 Monate |
| Konzentrationsquote | Anteil kritischer Geschäftsprozesse, die von genau einem Anbieter abhängen | Jährlich sinkend |
| Übungsquote | Anteil der Mitarbeitenden, die den Notfallkanal in den letzten 6 Monaten genutzt haben | > 80 % |
| Ausfallkosten pro Stunde | Bezifferter Produktivitäts- und Umsatzverlust | Bekannt (überhaupt eine Zahl zu haben, ist bereits Fortschritt) |
Guardrails:
- Keine Vertragsverlängerung bei kritischen Cloud-Diensten ohne dokumentierte Exit-Option.
- Kein neuer Prozess, der ausschließlich auf einem Anbieter läuft, ohne Freigabe durch BCM.
- Nach jedem Großausfall eines Hauptanbieters: Post-Mortem im eigenen Haus, nicht nur das Lesen des Microsoft-Berichts.
Fallbeispiel: Ein Mittelständler am 12. November
Annahmen (illustrativ, keine Erhebung):
- 80 Mitarbeitende, Dienstleistung B2B, vollständig auf M365
- Ausfall Donnerstag ab 17 Uhr, Wiederherstellung Freitag gegen Mittag
- Betroffen: ca. 1 Stunde am Donnerstag, ca. 4 Stunden am Freitagvormittag
- Produktivitätsverlust in dieser Zeit: geschätzt 50 %
- Vollkostensatz: 70 € pro Stunde und Person
Rechnung: 80 Personen × 5 Stunden × 50 % × 70 € = 14.000 € direkter Produktivitätsverlust – für einen einzigen Vorfall.
Nicht eingerechnet: verpasste Angebotsfristen, Kunden, die keine Antwort bekamen, Rückstau-Abarbeitung, IT-Überstunden.
SLA-Gutschrift dagegen: Ein Bruchteil der monatlichen Lizenzgebühr – sofern die Verfügbarkeit im Monatsmittel überhaupt unter die Schwelle fällt und jemand den Antrag stellt.
Gegenrechnung Second Channel: Unabhängiger Messenger plus Notfall-E-Mail-Postfächer plus Übungsaufwand – grob 5.000 bis 10.000 € pro Jahr. Bei sechs Vorfällen in elf Monaten muss ich dir die Amortisation hoffentlich nicht vorrechnen.
60-Minuten-Checkliste für Montag
- Kannst du alle Mitarbeitenden erreichen, wenn Outlook und Teams ausfallen? Wie genau?
- Liegt dein Notfallplan außerhalb des Microsoft-Tenants?
- Gibt es Break-Glass-Zugänge, die nicht von Entra ID abhängen?
- Kennst du eure Ausfallkosten pro Stunde?
- Weißt du, welche Drittsysteme per SSO an Microsoft hängen?
- Hat dein IT-Dienstleister einen dokumentierten Plan für 24 Stunden M365-Ausfall?
- Wurde jemals getestet, wie lange ein Export aus Exchange oder SharePoint dauert?
- Gibt es eine dokumentierte Managemententscheidung, dass das Konzentrationsrisiko akzeptiert wird?
Wenn du bei mehr als drei Punkten „nein“ oder „weiß nicht“ ankreuzt: Das ist dein Projekt für Q1.
FAQ
War der Microsoft-Ausfall im November 2026 ein Cyberangriff? Nein, laut Microsoft gibt es keine Hinweise auf böswillige Aktivitäten. Der Konzern nannte fehlschlagende Health-Checks, überlastete Verbindungskomponenten und eine zurückgerollte Netzwerkkonfiguration. Eine offizielle Root Cause steht noch aus.
Welche Regierungen waren betroffen? Öffentlich bestätigt wurden unter anderem das US-Repräsentantenhaus, die japanische Regierungs-IT, Singapurs Behörden-E-Mail, australische Sicherheitsbehörden, der Supreme Court der Philippinen und Teile des britischen NHS. Die deutsche Bundesverwaltung war nach eigenen Angaben nicht umfassend betroffen.
Ist eine eigene On-Premises-Lösung nicht noch unzuverlässiger? Im Durchschnitt oft ja. Aber es geht nicht um „Cloud oder Keller“, sondern um Konzentrationsrisiko. Ein eigener Ausfall trifft dich allein, ein Hyperscaler-Ausfall trifft dich, deine Kunden, deine Lieferanten und deine Behörde gleichzeitig.
Bringt ein Wechsel zu AWS oder Google etwas? Für die Souveränitätsfrage kaum. Du tauschst einen US-Hyperscaler gegen einen anderen. Für die Verfügbarkeit hilft nur Diversifizierung oder ein unabhängiger Second Channel.
Was bringt mir das Microsoft-SLA? Eine Gutschrift auf Lizenzgebühren, wenn die zugesagte Verfügbarkeit unterschritten wird. Keinen Ersatz für deinen Produktivitätsverlust oder Folgeschäden.
Muss ich jetzt komplett aus Microsoft 365 aussteigen? Nein. Du musst wechselfähig werden und die kritischsten Funktionen absichern. Ausstieg ist eine Option, Exit-Fähigkeit ist eine Pflicht.
Gibt es europäische Alternativen, die produktionsreif sind? Für E-Mail, Chat, Dateiablage und Office-Bearbeitung gibt es etablierte europäische und Open-Source-Lösungen. Sie sind in Teilen weniger integriert, dafür austauschbar. Prüfe sie an einem echten Teilprozess, nicht an einer Feature-Liste.
Was sollte ich von meinem IT-Dienstleister konkret verlangen? Ein dokumentiertes Szenario für mindestens 24 Stunden Totalausfall des Hauptanbieters, inklusive Kommunikationsweg, Zuständigkeiten und Kosten. Kann er das nicht liefern, kauft ihr Lizenzverwaltung, keine Resilienz.
Fazit: Der nächste Ausfall ist bereits terminiert – du kennst nur das Datum noch nicht
Der Microsoft-Ausfall vom 12. und 13. November 2026 ist kein Schwarzer Schwan. Er ist das erwartbare Ergebnis einer Architektur, in der Regierungen, Konzerne und Mittelständler ihre gesamte Kommunikation über die Infrastruktur eines einzigen Anbieters abwickeln – und das als „Digitalisierung“ verbuchen.
Die Frage „Was muss noch passieren?“ hat eine unbequeme Antwort: Wahrscheinlich nichts mehr. Es ist alles schon passiert. Die Ausfälle sind da, die Kosten sind da, die Abhängigkeit ist offensichtlich. Was fehlt, ist nicht Erkenntnis. Es ist Entscheidung.
Meine klare Empfehlung: Behandle Kommunikation und Identität als kritische Infrastruktur. Bau einen unabhängigen Second Channel. Mach Exit-Fähigkeit zur Vertragsbedingung – gegenüber Microsoft und gegenüber deinem IT-Dienstleister.
Next Step: Setz dich nächste Woche 60 Minuten mit der Checkliste oben hin. Danach weißt du, wie verwundbar du bist. Alles Weitere ist Umsetzung.
Stop doing:
1. Hör auf, „Microsoft fällt schon nicht aus“ als Risikobewertung zu akzeptieren.
2. Hör auf, Notfallpläne im selben System zu speichern, dessen Ausfall sie abdecken sollen.
3. Hör auf, Verträge mit Hyperscalern ohne dokumentierte Exit-Option zu verlängern.
4. Hör auf, IT-Dienstleister als „Berater“ zu bezahlen, die nur einen Hersteller kennen.
5. Hör auf, digitale Souveränität in Strategiepapieren zu fordern und gleichzeitig Copilot-Lizenzen zu verlängern.
6. Hör auf, SLA-Prozentwerte mit Betriebssicherheit zu verwechseln.
7. Hör auf, nach jedem Ausfall „Lessons Learned“ zu sagen, ohne dass sich danach etwas ändert.
Quellen (Stand 13.11.2026)
- Al Jazeera: Microsoft hit by global outages: What happened and why? – https://www.aljazeera.com/news/2026/11/13/microsoft-hit-by-global-outages-what-happened-and-why
- SecurityWeek: Microsoft 365 Outage Disrupts Outlook, Exchange Online and Teams – https://www.securityweek.com/microsoft-365-outage-disrupts-outlook-exchange-online-and-teams/
- Reuters via Star Advertiser: Microsoft outage disrupts businesses, governments worldwide – https://www.staradvertiser.com/2026/11/13/breaking-news/microsoft-outage-disrupts-businesses-and-governments-worldwide/
- Reuters via Yahoo News: Hours-long Microsoft outage disrupts businesses, governments globally – https://sg.news.yahoo.com/microsoft-outage-drags-hours-disrupting-233132005.html
- Reuters via TimesLIVE: The Microsoft outage that's hit state agencies and business alike – https://www.timeslive.co.za/news/sci-tech/2026-11-13-microsoft-outage-drags-on-for-hours-disrupting-outlook-teams-for-businesses-and-governments/
- AP via News4Jax: Microsoft struggles to restore services as outage hits companies and governments worldwide – https://www.news4jax.com/business/2026/11/13/microsoft-outage-hits-companies-and-governments-worldwide-as-it-struggles-to-restore-services/
- TIME: Microsoft Teams, Outlook Worldwide Outage – https://time.com/article/2026/11/13/microsoft-outage-worldwide-disruption-teams-outlook-emails/
- Euronews: Microsoft outage latest – https://www.euronews.com/2026/11/12/microsoft-outage-hits-outlook-teams-and-copilot-disrupting-thousands
- TechCrunch: Microsoft's latest email outage turned into a full blown global cloud crisis – https://techcrunch.com/2026/11/12/microsofts-outlook-email-hit-by-new-outage/
- Windows Central: Microsoft 365, Outlook, Teams, OneDrive, and Copilot are still down – https://www.windowscentral.com/microsoft/azure/microsoft-365-outlook-teams-onedrive-and-copilot-are-all-down-right-now
- azureblog.co.uk: Microsoft 365 outage, 12 November 2026 – https://azureblog.co.uk/posts/microsoft-365-outage-12-november-2026/
- IT-Journal: Microsoft-Störung: Keine größeren Ausfälle in Bundesverwaltung – https://www.it-journal.de/223160-microsoft-stoerung-keine-groesseren-ausfaelle-in-bundesverwaltung.html
- it-daily: Microsoft-Ausfall: Bayern warnt vor IT-Abhängigkeit – https://www.it-daily.net/shortnews/microsoft-ausfall-it-abhaengigkeit
- BayernSPD Landtag: SPD zu Microsoft-Ausfall – https://bayernspd-landtag.de/presse/pressemitteilungen/?id=1236198
- heise online: Microsoft-Cloud-Ausfall: E-Mail-Zugriff läuft wieder an – https://www.heise.de/news/Microsoft-Cloud-Ausfall-E-Mails-weiterhin-nicht-zugreifbar-11524008.html
- ORF: Weltweite Ausfälle bei Microsoft-Diensten – https://orf.at/stories/3448057/
- Dr. Windows: Outlook, Microsoft 365 und weitere Dienste erholen sich – https://www.drwindows.de/news/outlook-microsoft-365-und-weitere-dienste-derzeit-offenbar-massiv-gestoert
- Vorfälle 2026 (Kontext): The Register (Januar), w.media (Juli), Glitchwire (August), IsDown (9. November)
Featured Stories

14 DSGVO-konforme Alternativen zu Google Analytics 4 im Vergleich
Trend-Alarm: "Boutique-Agenturen", oder die Gentrifizierung des Scheiterns
Verlorenes Vertrauen: Warum Google für SEOs zur Blackbox geworden ist
Google Tools und DSGVO: Was du wirklich brauchst, was du lassen kannst
Gibt es eine absichtliche Benachteiligung von VPN-Nutzern durch SaaS-Anbieter?